"Gitea 서버 DB Pod가 죽었으니 재기동 좀 해주세요." 이 한 줄의 보고로 시작했다. 들여다보니 단일 Pod 문제가 아니었다. placeholder 이미지(image: url)를 단 채 매시간 도는 더미 CronJob 2개가 ImagePullBackOff Pod를 한 노드에 360개 넘게 쌓았고, 그 Pod 더미가 노드 하나의 kubelet을 마비시켰다. 그 노드 위에 있던 PostgreSQL primary가 같이 묻히면서 Git 서버의 DB HA가 무너졌고, 노드가 빠진 자리에 워크로드가 쏠리며 캐시(Valkey)의 묵은 손상과 백엔드 기동 실패까지 한꺼번에 표면으로 올라왔다. 이 글은 그 연쇄를 어떻게 풀어 내려갔는지, 그리고 같은 일이 다시 일어나지 않게 하려면 어디를 막아야 하는지 정리한 기록이다.
Intro
- 단일 트리거: placeholder 이미지(
image: url)를 둔 채 매시간 실행되는 더미 CronJob 2종이 ImagePullBackOff Pod를 한 노드에 수백 개(하나는 360개) 누적시켰다. - 노드 마비(zombie): 그 Pod 더미가
worker-node-1의 kubelet을 과부하시켜, control plane에는 Ready heartbeat를 보내면서도 Pod 종료(Terminating)는 처리하지 못하는 zombie 상태로 만들었다. - 연쇄 1 (DB): 그 노드에 갇힌 PostgreSQL primary가 도달 불가가 되면서 standby가 follow를 못 하고, pgpool readiness가 실패해 Git 서버 DB HA가 다운됐다.
- 연쇄 2 (쏠림): 노드 부재로 워크로드가 나머지 worker 2대로 쏠려 메모리가 95% / 99%까지 포화됐고, 그 여파로 캐시(
valkey-0)의 7일 된 AOF 손상과 백엔드 member 서비스 기동 실패가 함께 드러났다. - 복구 결과: 더미 CronJob 정리(ImagePullBackOff 0) → 노드 회복 → 캐시 3/3 HA → 백엔드 4/4 → PostgreSQL 3/3 HA까지 순서대로 복구.
- 핵심 교훈: ImagePullBackOff Pod 하나는 가볍다. 하지만 수백 개가 한 노드에 쌓이면 kubelet의 Pod sync 루프를 마비시킨다. placeholder 이미지로 매시간 도는 CronJob은 조용한 시한폭탄이다. 그리고 그 더미가 포탈 정식 경로로 검증 없이 생성됐다는 점이, 재발 방지의 출발점을 코드 단으로 끌어왔다.
시점 컨텍스트
이 글이 다루는 환경은 공용(common) 클러스터의 alpha 한 곳이다. 사내 플랫폼을 여러 사업장에 솔루션 형태로 납품하는 구조라, 모든 추가 개발과 QA가 alpha에서 먼저 진행된다. 그래서 본문의 "장애 / 복구 / 재발 방지"는 prod 운영 사고가 아니라 alpha 환경에서 만난 사건과 그 대응으로 읽으면 된다. 재발 방지 로드맵의 우선순위도 "alpha에서 깔끔히 막아두고 beta · prod 진입 전에 끝내자"가 전제다.
1. 출발점: "Pod 하나 재기동" 인 줄 알았던 노드 레벨 장애
처음 받은 보고는 단순했다. Git 서버(gitea 네임스페이스)의 PostgreSQL Pod가 죽었으니 재기동이 필요하다는 것. 그런데 kubectl get pods 를 띄워보니 단일 Pod 문제가 아니었다. PostgreSQL Pod 여러 개가 Terminating 으로 며칠째 멈춰 있었고, 그게 전부 한 노드(worker-node-1)에 몰려 있었다.
노드를 봤다.
kubectl get nodes
# worker-node-1 NotReady ...NotReady. 그리고 노드에는 node.kubernetes.io/not-ready:NoExecute taint가 붙어 있었다. 그런데 이상한 점이 있었다. NotReady인데도 control plane으로는 Ready heartbeat를 다시 보내기 시작한 상태였고, 그 노드의 kubelet API(:10250)는 이렇게 응답했다.
net/http: TLS handshake timeout로그 조회조차 안 됐다. Pod들은 phase가 Running 인데 Terminating 이 진행되지 않고, finalizer도 없었다(finalizers=[]). 전형적인 zombie kubelet 패턴이었다. 노드는 "살아있다"고 보고하지만 정작 Pod lifecycle은 한 발짝도 못 움직이는 상태.
여기서 첫 번째 판단을 했다. "Pod를 재기동"하는 작업이 아니라, 이 노드가 왜 이 지경이 됐는지부터 찾아야 한다.
2. 진단: 노드를 마비시킨 진짜 범인
노드에 쌓인 Pod를 네임스페이스별로 세어봤다. 답이 빠르게 나왔다.
| CronJob | 네임스페이스 | 스케줄 | 문제 | 누적 Pod |
|---|---|---|---|---|
hourly-trigger-test |
argo-rollouts |
0 * * * * (매시간) |
컨테이너 이미지가 placeholder url |
360개 ImagePullBackOff |
qa-dummy-cronjob |
argo-rollouts-demo |
0 * * * * (매시간) |
동일 (image: url) + concurrencyPolicy: Allow, restartPolicy: OnFailure |
수십~118개 |
두 CronJob 모두 컨테이너 이미지를 url 이라는 placeholder 문자열 그대로 두고 있었다. 당연히 이미지 pull은 매번 실패하고, Pod는 ImagePullBackOff로 남는다. 그런데 이게 매시간 돈다. 한쪽은 concurrencyPolicy: Allow 라 이전 실행이 안 끝나도 새 Job을 계속 만들어내며 무한히 누적됐다.
보호 대상과 범인을 분리하는 건 중요했다. argo-rollouts 네임스페이스의 컨트롤러(argo-rollouts-*)는 정상 동작 중이었고, 범인은 hourly-trigger-test* 이름을 가진 Pod들만 해당했다. 이름 prefix로 명확히 구분되어 한꺼번에 지워도 컨트롤러는 다치지 않았다.
가장 뼈아팠던 사실은 생성 경로였다. 두 더미 모두 플랫폼 포탈을 통해 사용자가 더미식으로 만든 workload였다. 즉 포탈의 정식 워크로드 생성 경로로 placeholder 이미지(url)가 아무 검증 없이 통과되어 만들어진 것이다. 이건 단순히 "QA가 더미를 잘못 만들었다"로 끝낼 문제가 아니라, 포탈이 이런 입력을 막지 못했다는 뜻이었다. 재발 방지의 무게중심이 여기서 코드 단으로 옮겨갔다.
3. 연쇄 구조: 더미 Pod 하나가 DB와 캐시 양쪽으로
핵심은 단일 트리거가 어떻게 서로 무관해 보이는 두 시스템(Git 서버 DB / 플랫폼 캐시·백엔드)을 동시에 무너뜨렸는가다.
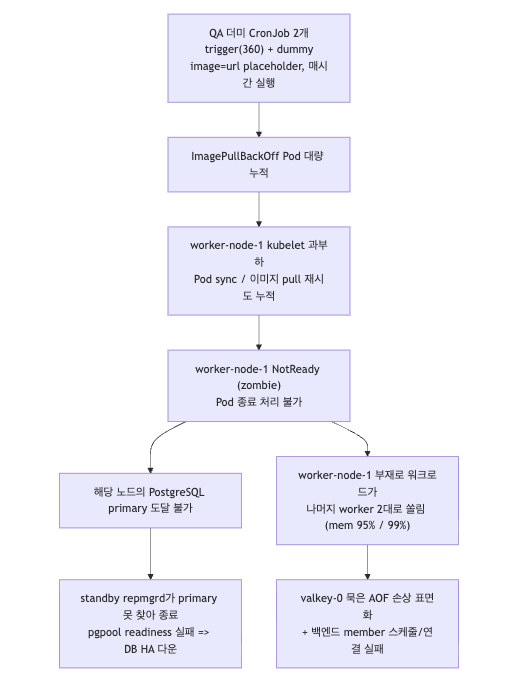
한 줄로 요약하면, 단일 트리거(더미 CronJob)가 노드 장애를 만들고, 노드 장애가 DB와 캐시·백엔드 양쪽으로 갈라져 전파됐다. 캐시(valkey-0)의 AOF 손상은 사실 7일 전부터 따로 있던 묵은 이슈였는데, 이번 장애를 점검하는 과정에서 같이 드러나 함께 복구하게 됐다.
4. 복구: 6단계로 내려간 순서
복구는 "원인 제거 → 노드 회복 → 의존성 역순 복구" 흐름으로 잡았다. 순서 자체가 곧 설계였다.
4.1 PostgreSQL HA 1차 복구 (zombie 노드 대응)
PostgreSQL은 repmgr 기반 HA였다. primary가 postgresql-1, standby가 -0 / -2. 하필 primary가 zombie 노드에 갇혀 있어, standby들이 primary를 follow하지 못하는 상태였다.
먼저 스토리지부터 확인했다. 데이터가 NFS 백엔드(nfs.csi.k8s.io, Reclaim=Retain) 위에 있어 노드에 종속되지 않는다는 점이 결정적이었다. 즉 Pod를 다른 노드로 재배치해도 데이터 유실 위험이 낮다. 이게 확인되자 force delete를 선택할 수 있었다.
# 신규 스케줄을 정상 노드로 유도
kubectl cordon worker-node-1

# Terminating stuck 된 primary/standby 강제 정리 → StatefulSet이 정상 노드에 재생성
kubectl delete pod -n gitea \
  <pg-statefulset>-1 <pg-statefulset>-2 \
  --grace-period=0 --force
재생성된 primary가 crash recovery로 정상 기동(database system is ready to accept connections)했고 standby가 follow를 완료했다. worker-node-1 자체는 뒤에서 더미 Pod를 정리하자 자연 회복돼 이후 uncordon했다.
force delete는 만능이 아니다. NFS 동시 쓰기 위험이 있어, PostgreSQL처럼 postmaster.pid lock 같은 자체 보호 장치가 있는 컴포넌트인지 먼저 확인하고 들어가야 한다.
4.2 더미 CronJob 정리 (근본 원인 제거)
노드를 살리는 진짜 약은 범인 Pod 제거였다.
# 매시간 신규 실패 Pod 생성부터 멈춘다
kubectl patch cronjob -n argo-rollouts hourly-trigger-test -p '{"spec":{"suspend":true}}'
kubectl get jobs -n argo-rollouts -o name | grep trigger-test | xargs -r kubectl delete -n argo-rollouts

# 누적 Pod 360개 일괄 삭제 (컨트롤러 argo-rollouts-* 는 이름이 달라 제외됨)
kubectl get pods -n argo-rollouts -o name | grep '^pod/trigger-test-' \
  | xargs -r -n 50 kubectl delete -n argo-rollouts --grace-period=0
qa-dummy-cronjob 도 같은 패턴으로 suspend + Job/Pod 정리. 정의 자체는 지우지 않고 suspend로 보존했다. QA 담당자 소유 리소스라 임의 삭제보다 정지를 택했다. 결과적으로 전체 클러스터의 ImagePullBackOff / ErrImagePull이 0이 됐다.
4.3 캐시(valkey-0) AOF 손상 복구
valkey-0(replica)이 Bad file format reading the append only file 로 7일째 CrashLoop이었다. master(valkey-1)는 정상이었고, sentinel 3개도 정상. 다만 StatefulSet의 OrderedReady 정책 탓에 valkey-0이 not-ready라 valkey-2 생성도 막혀 1/3 상태였다.
valkey-0은 replica이므로 master 데이터가 정본이다. 손상 데이터를 비우고 master에서 full resync를 받게 하면 된다. 문제는 RWO PVC를 손대야 한다는 것이었는데, 여기서 한 가지 우회가 통했다.
RWO 충돌 우회: PVC를 두 Pod가 동시에 잡으면 Multi-Attach로 막힌다. 하지만 백엔드가 NFS라면, PVC가 아니라 NFS server/path를 직접 마운트한 임시 Pod를 띄워 손상 데이터를 만질 수 있다. RWO 충돌 없이 손상본을 백업(삭제 아님)으로 옮겼다.
# 임시 Pod가 NFS subdir 직접 마운트 → 손상 데이터를 삭제가 아니라 rename(백업)
mv appendonlydir appendonlydir.broken.<timestamp>
mv dump.rdb       dump.rdb.broken.<timestamp>

# valkey-0 재기동 → master에서 full resync
kubectl delete pod -n <portal-ns> valkey-0
valkey-0 로그에 Full resync from master, MASTER <-> REPLICA sync: Finished with success 가 찍혔다. valkey-0이 Ready가 되자 OrderedReady가 valkey-2를 자동 생성했고 캐시 3/3 HA가 복구됐다. 손상 원본은 .broken.<timestamp> 로 남겨 두어, 복구가 틀어졌을 때 직전 상태로 되돌릴 수 있게 했다.
4.4 백엔드 재기동 (be 내림 → 캐시 → be 올림)
백엔드 member 서비스가 valkey-0 headless DNS를 NXDOMAIN으로 받으며 CrashLoop이었다. valkey-0이 죽으면서 headless A레코드가 사라진 탓이다. 즉 캐시 복구가 선행 조건이었고, 순서를 명시적으로 잡았다.
# 1) 백엔드 전체 정지
kubectl scale deploy -n <portal-ns> \
  be-gateway-deploy be-kube-deploy be-member-deploy be-portal-deploy --replicas=0
# 2) 캐시 복구 (4.3)
# 3) 백엔드 재기동
kubectl scale deploy -n <portal-ns> \
  be-gateway-deploy be-kube-deploy be-member-deploy be-portal-deploy --replicas=1
재기동 후 member 로그상 캐시를 sentinel 모드(mode=sentinel, master=mymaster)로 정상 연결했고, 백엔드 4/4 Ready가 됐다.
4.5 GPU 노드 워크로드 재배치
장애 동안 가용 노드가 부족했던 데다, GPU 노드의 GPU 전용 taint가 노드 재시작 때 소실되며 다수의 일반 워크로드(argocd, keycloak, gitea, monitoring 등)가 GPU 노드로 흘러 들어가 있었다. 이걸 worker로 돌려보냈다.
GPU=gpu-node
kubectl cordon $GPU
# DaemonSet(node-exporter, nvidia-*, calico 등)은 제외하고 재배치
for ns in argocd keycloak gitea monitoring openbao sonarqube tekton-pipelines; do
  kubectl get pods -n $ns --field-selector spec.nodeName=$GPU \
    -o jsonpath='{range .items[?(@.metadata.ownerReferences[0].kind!="DaemonSet")]}{.metadata.name}{"\n"}{end}' \
    | xargs -r kubectl delete pod -n $ns
done
DaemonSet은 노드 고정 워크로드라 제외하는 게 핵심이다. 대상 Pod는 전부 worker로 이동했고, 마무리 시 GPU 노드를 uncordon했다.
4.6 PostgreSQL standby 클린 재조인 (repmgr 메타 정리)
마지막 난관. 재배치된 postgresql-0(standby)이 clone(약 5분)은 성공하는데, 직후 startup 단계에서 exit 1을 반복했다. liveness initialDelaySeconds를 임시로 늘려도 동일 → probe race가 아니라 standby register 단계 실패로 판단했다.
원인은 primary의 repmgr 메타데이터에 있었다. node 1000이 active=f 로 남은 stale 메타가 fresh register와 충돌하고 있었다.
# stale 메타 제거 (컨테이너 user 문제로 repmgr CLI 대신 psql 직접 사용)
kubectl exec -n gitea <pg-statefulset>-1 -c postgresql -- \
  bash -ec 'PGPASSWORD=$REPMGR_PASSWORD psql -U repmgr -d repmgr \
  -c "DELETE FROM repmgr.nodes WHERE node_id=1000;"'

# 데이터 PVC 초기화 후 fresh clone 유도 (NFS Retain이라 이전 PV는 Released로 보존)
kubectl delete pvc -n gitea data-<pg-statefulset>-0 --wait=false
kubectl delete pod -n gitea <pg-statefulset>-0 --grace-period=0 --force
Bitnami 계열 컨테이너에서 repmgr CLI가 could not get current user name(uid가 /etc/passwd에 없음)으로 실패하는 경우, 메타 조작은 psql로 직접 하는 우회가 현실적이다.
최종적으로 postgresql-0이 정상화됐고, repmgr.nodes 의 세 노드가 모두 active=t, PostgreSQL 3/3 HA가 복구됐다.
최종 상태
| 항목 | 결과 |
|---|---|
| 전체 노드 | 모두 Ready |
| PostgreSQL | 3/3 + pgpool, repmgr 3노드 active=t |
| 캐시(Valkey) | 3/3 HA |
| 백엔드 | 4/4 Ready (sentinel 연결 정상) |
| ImagePullBackOff | 0 |
5. 잔존 리스크: 의도적으로 남겨둔 것
복구를 끝냈다고 원래 상태로 100% 되돌린 건 아니다. PostgreSQL standby 복구 과정에서 StatefulSet 설정 두 개를 임시 변경했고, 의도적으로 유지하고 있다.
| 항목 | 변경값 | 원래값 |
|---|---|---|
updateStrategy.type |
OnDelete |
RollingUpdate |
livenessProbe.initialDelaySeconds |
1200 |
300 |
판단 근거는 이렇다. NFS clone이 느린 환경(수백 MB에 5분+)에서는 initialDelaySeconds=1200 이 오히려 적합하고, 원래값으로 되돌리는 순간 RollingUpdate가 primary를 재시작시킬 리스크가 있다. 그래서 지금은 유지하되, OnDelete 라 Helm 차트 업데이트가 Pod에 자동 반영되지 않는다는 점은 명시적으로 인지하고 있다. 정식 정책화 여부는 후속 과제로 남겼다.
응급 복구 경로도 메모로 남겼다.
- 캐시 복구 실패 시:
appendonlydir.broken.<timestamp>를 원래 이름으로 되돌려 직전 상태 복원. - standby 재조인 실패 시:
repmgr.nodes의 stale 노드 제거 + 데이터 PVC 초기화 후 fresh clone.
6. 재발 방지: 막아야 할 곳은 "포탈 입력 단"
이번 장애에서 가장 중요한 사실은, 범인 더미가 포탈 정식 경로로 검증 없이 생성됐다는 점이다. 그러니 진짜 차단책은 노드 운영 쪽이 아니라 포탈 입력 단에 있다.
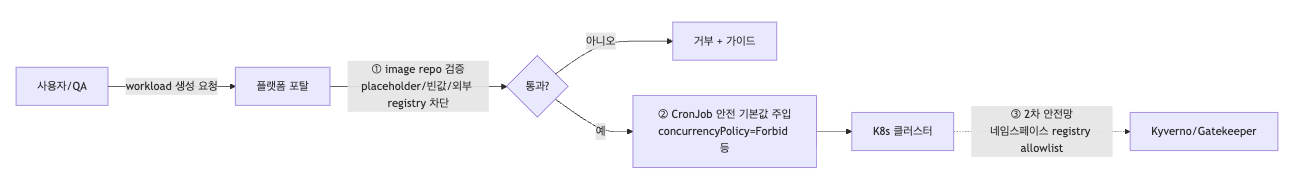
우선순위는 세 가지다.
- (필수) image repository 검증·고정: 포탈에서 워크로드를 만들 때 placeholder(
url등)·빈 값·외부 registry(Docker Hub) 입력을 차단하고, 환경별 Harbor 경로를 기본값으로 주입한다. alpha/beta는 registry 미지정 시 Docker Hub로 pull되며 rate limit에 걸리고, prod(폐쇄망)는 Docker Hub 도달 자체가 불가하므로 Harbor 경로를 강제하고 사용자 가이드를 붙여야 한다. 이게 이번 장애의 직접 차단책이다. global: image: repository: harbor.<site>/library/be-member # Harbor 경로 명시(검증 통과 필수) tag: "release-x.y.z" # 가급적 immutable 태그 pullPolicy: IfNotPresent- (필수) CronJob 안전 기본값 강제: 포탈에서 CronJob을 만들 때
concurrencyPolicy: Forbid,failedJobsHistoryLimit/successfulJobsHistoryLimit축소를 기본으로 주입한다. 이미지 경로가 올바르더라도 오타·없는 태그면 ImagePullBackOff가 생기고, 노드를 마비시킨 직접 원인은 결국 그 실패 Pod의 무한 누적이었다. 이번 더미 하나가concurrencyPolicy: Allow였던 게 누적을 키웠다. - (선택) 2차 안전망: 포탈 외(kubectl/argo) 생성 경로가 열려 있다면, 네임스페이스 단위 registry allowlist(Kyverno/Gatekeeper, 허용
harbor.<site>/*)를 admission 단에 두어 포탈을 우회한 입력까지 막는다.
이 외에 인프라 쪽 후속도 남겼다. GPU 노드 taint 소실 방지(nodeSelector 적용 또는 taint 영구화), 단일 노드 장애 시 쏠림 완화(핵심 워크로드 requests/limits 재점검, PodDisruptionBudget 검토), 그리고 PostgreSQL 컨테이너 로그에 repmgr 자격증명이 평문으로 찍히는 문제의 로그 마스킹 검토다.
7. 마무리: 이번 장애가 남긴 다섯 줄
복구 명령보다 오래 남을 자산은 결국 "다음에 같은 신호를 봤을 때의 사고 흐름"이다.
- 가벼운 실패도 누적되면 노드를 죽인다. ImagePullBackOff Pod 하나는 무해하지만, 수백 개가 한 노드에 쌓이면 kubelet의 Pod sync 루프가 마비된다. placeholder 이미지로 매시간 도는 CronJob은 조용한 시한폭탄이다.
- zombie 노드는 "살아있다고 거짓말하는" 노드다. control plane엔 Ready heartbeat를 보내면서 Pod 종료만 못 한다. Terminating stuck Pod는
--grace-period=0 --force로 풀되, 자체 lock 보호가 있는 컴포넌트인지 먼저 본다. - RWO PVC는 NFS 백엔드면 우회로가 있다. 두 Pod가 PVC를 동시에 못 잡아도, server/path를 직접 마운트한 임시 Pod로 데이터를 안전하게 만질 수 있다.
- 손상 데이터는 지우지 말고 rename으로 백업한다.
.broken.<timestamp>한 번이 복구 실패 시의 마지막 안전선이 된다. - 막아야 할 곳은 장애가 터진 곳이 아니라 입력이 들어온 곳이다. 노드를 아무리 잘 살려도, 포탈이 placeholder 이미지를 계속 통과시키면 같은 일이 또 일어난다.
단일 트리거 하나가 서로 무관해 보이는 시스템들을 어떻게 도미노처럼 무너뜨리는지, 그리고 복구는 왜 항상 의존성의 역순이어야 하는지를 진하게 배운 하루였다.